工具与源码
灰字哥 v0.4.9 已上线 NEW
让多个模型帮你想下一句。新版修复了 Codex 普通候选单击后只填入、未发送的问题。
100 雷达积分兑换 macOS 安装包和源码。已兑换的用户可在同一页面重新下载更新。
让多个模型帮你想下一句。新版修复了 Codex 普通候选单击后只填入、未发送的问题。
100 雷达积分兑换 macOS 安装包和源码。已兑换的用户可在同一页面重新下载更新。
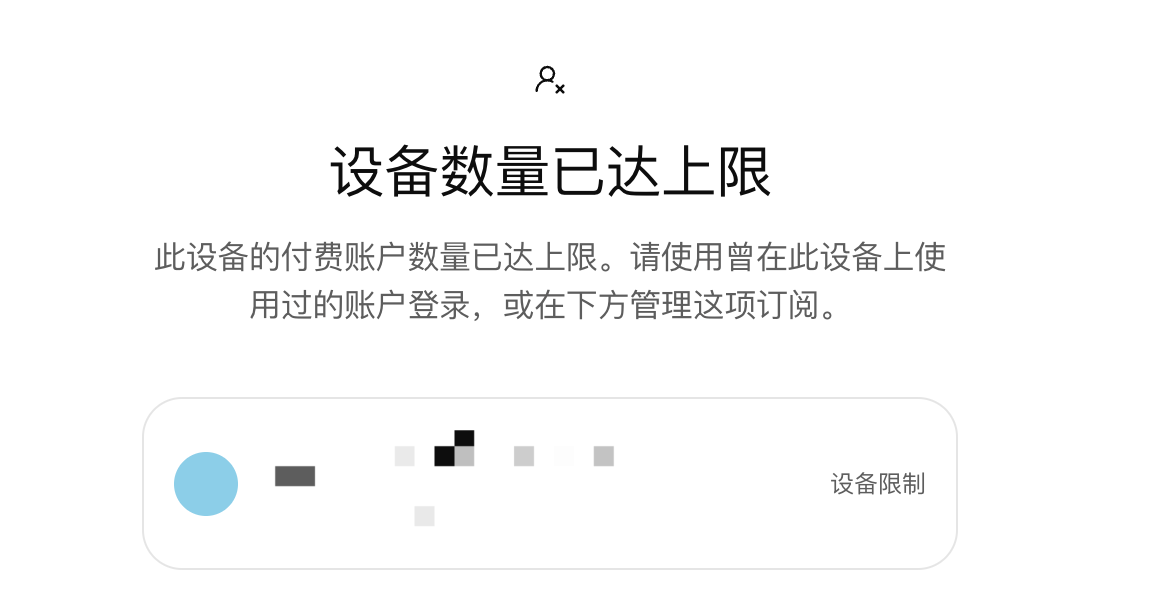
站长反馈:遇到设备付费账户数量达到上限的提示后,清理浏览器缓存和 Cookie,再重新登录后恢复。
1. 在用于登录的浏览器中清理缓存和 Cookie。2. 返回 Codex,重新登录。
这是社区实测经验,具体触发条件尚未核实。清理 Cookie 后需要重新登录。
用会话命名、24小时管理员 Goal 与实际桌面接口,搭建从派工到验收的协作流程。
兑换一次,同账号永久解锁本版。可先查看简介和目录。
100 雷达分兑换有多家模型混用需求的蹬友,推荐试试 Pi Agent + Pi-Web,再结合自定义插件,按自己的需求灵活组合。站长后续会分享具体玩法。
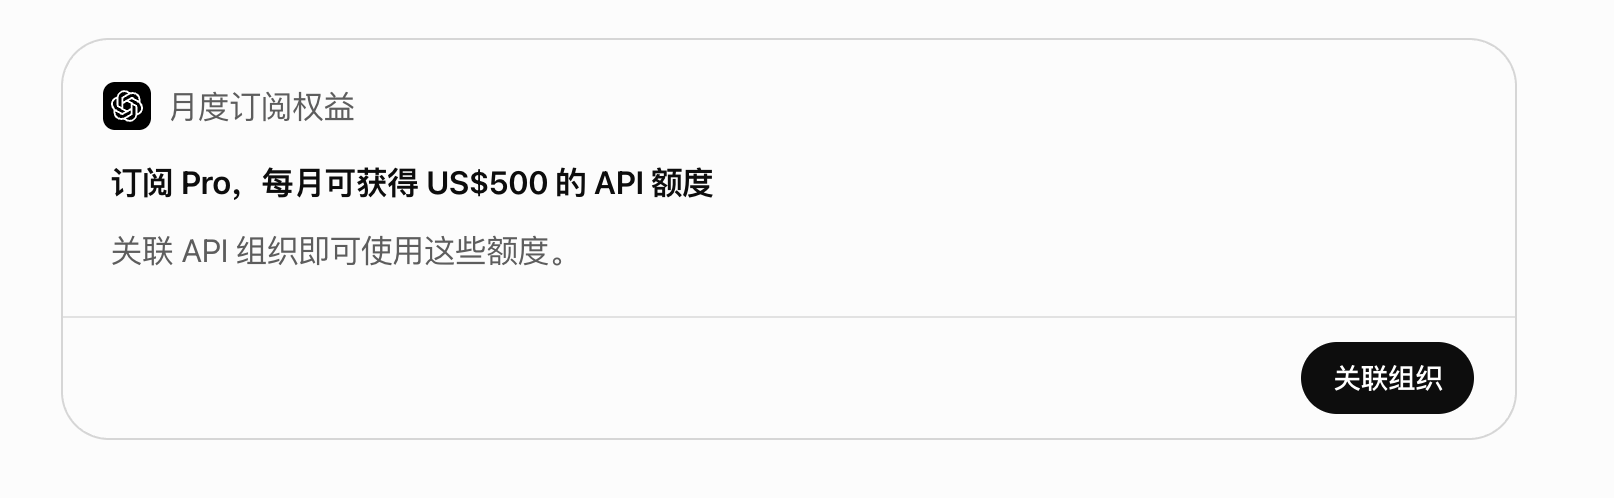
在 ChatGPT 领取,到 API Platform 使用,在 Credit grants 核到账,把额度用在真正需要的事情上。 独立阅读/分享本篇 ↗
符合资格的付费 ChatGPT Pro/Business 订阅可以领取 API 赠金。完整月度周期内,Pro 100/200/500 分别对应 $100/$200/$500;Business 按每个付费 Standard 席位 $20、Premium 席位 $100 汇总,每个工作区每月最高 $500。Plus 不在本活动范围内。
付费订阅需已生效至少7天。首笔按当前账期剩余时间折算,未用完的赠金随账期到期,不结转。年付 Business 按年度周期发放。是否能领还取决于账户、地区和活动开放情况,具体看账单页。
订阅到期后还能用吗?不再续订会停止后续赠金;已发赠金到记录的有效期后失效,不结转。取消自动续费后,已领赠金的有效期以 Credit grants 中的到期日为准。
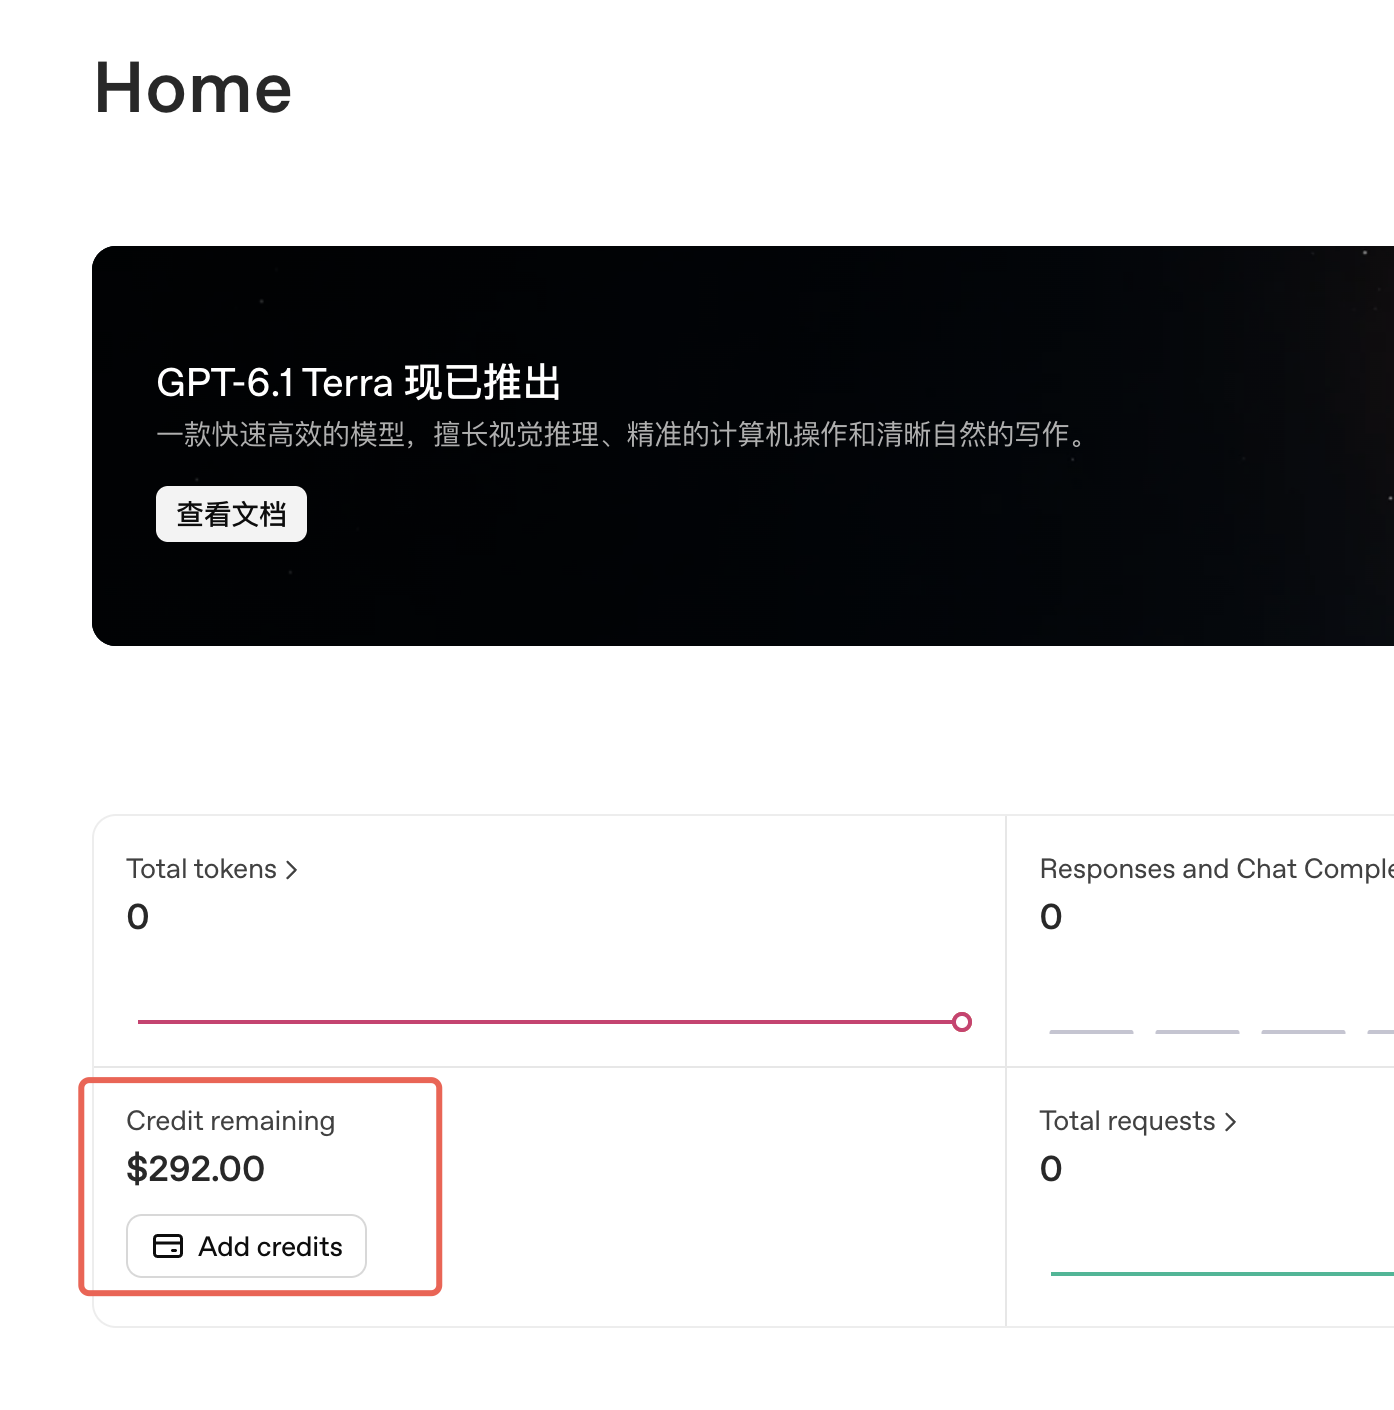
本月升级/变更套餐的案例:站长自述:10月10日从 Pro 100 升级到 Pro 200,10月29日首次领取到 $81。首笔需按当前订阅账期的剩余时间折算,不能直接把新档位的整月标称额度当作到账金额;$81 是这个账户的实例,不是 Pro 200 的固定额度,实际金额与有效期以领取页面和 Credit grants 为准。

去 API Platform ↗,可先用 Playground 体验,也可使用该组织项目的 API Key 接入自己的程序。支持的 API 用途涵盖文本/代码、Agent、图像、语音和工具。这份赠金不覆盖 API Key 方式的 Codex 用量,也不会增加 ChatGPT 或登录态 Codex 的订阅额度。具体模型权限、RPM/TPM 等限制仍然适用。
优先替代你原本就要付钱做的事情。下面是本站结合社区讨论给出的用途建议。
估算看 官方当前价格表 ↗,实际消耗看 Usage。赠金优先于已购买额度抵扣;赠金用完后,若组织还有付费余额,请求可能继续消耗付费余额。
据站长提供的社区素材与官方文档整理。截图为示例,具体资格、金额与有效期以本人账户为准;“API 思考更强”等群聊推测不作为本条结论。
桌面上看 Agent 状态,再和速蹬雷达一起玩。
它能在桌面悬浮球里显示 Codex、Claude Code 等工具的输出速度、并行状态和用量,让你随时知道 Agent 有多忙。开启上报后,再配合速蹬雷达看速度变化、逛实时天梯;一边工作,一边和蹬友比比速度,还能接 Token 挑战自己的纪录。好看,也方便观察自己的工作流。
指纹浏览器重置密码 → 开启/重开 2FA → 退出所有会话 → 24 小时内不登录
站长尝试3个美区降智号成功全部恢复并蹬完周限
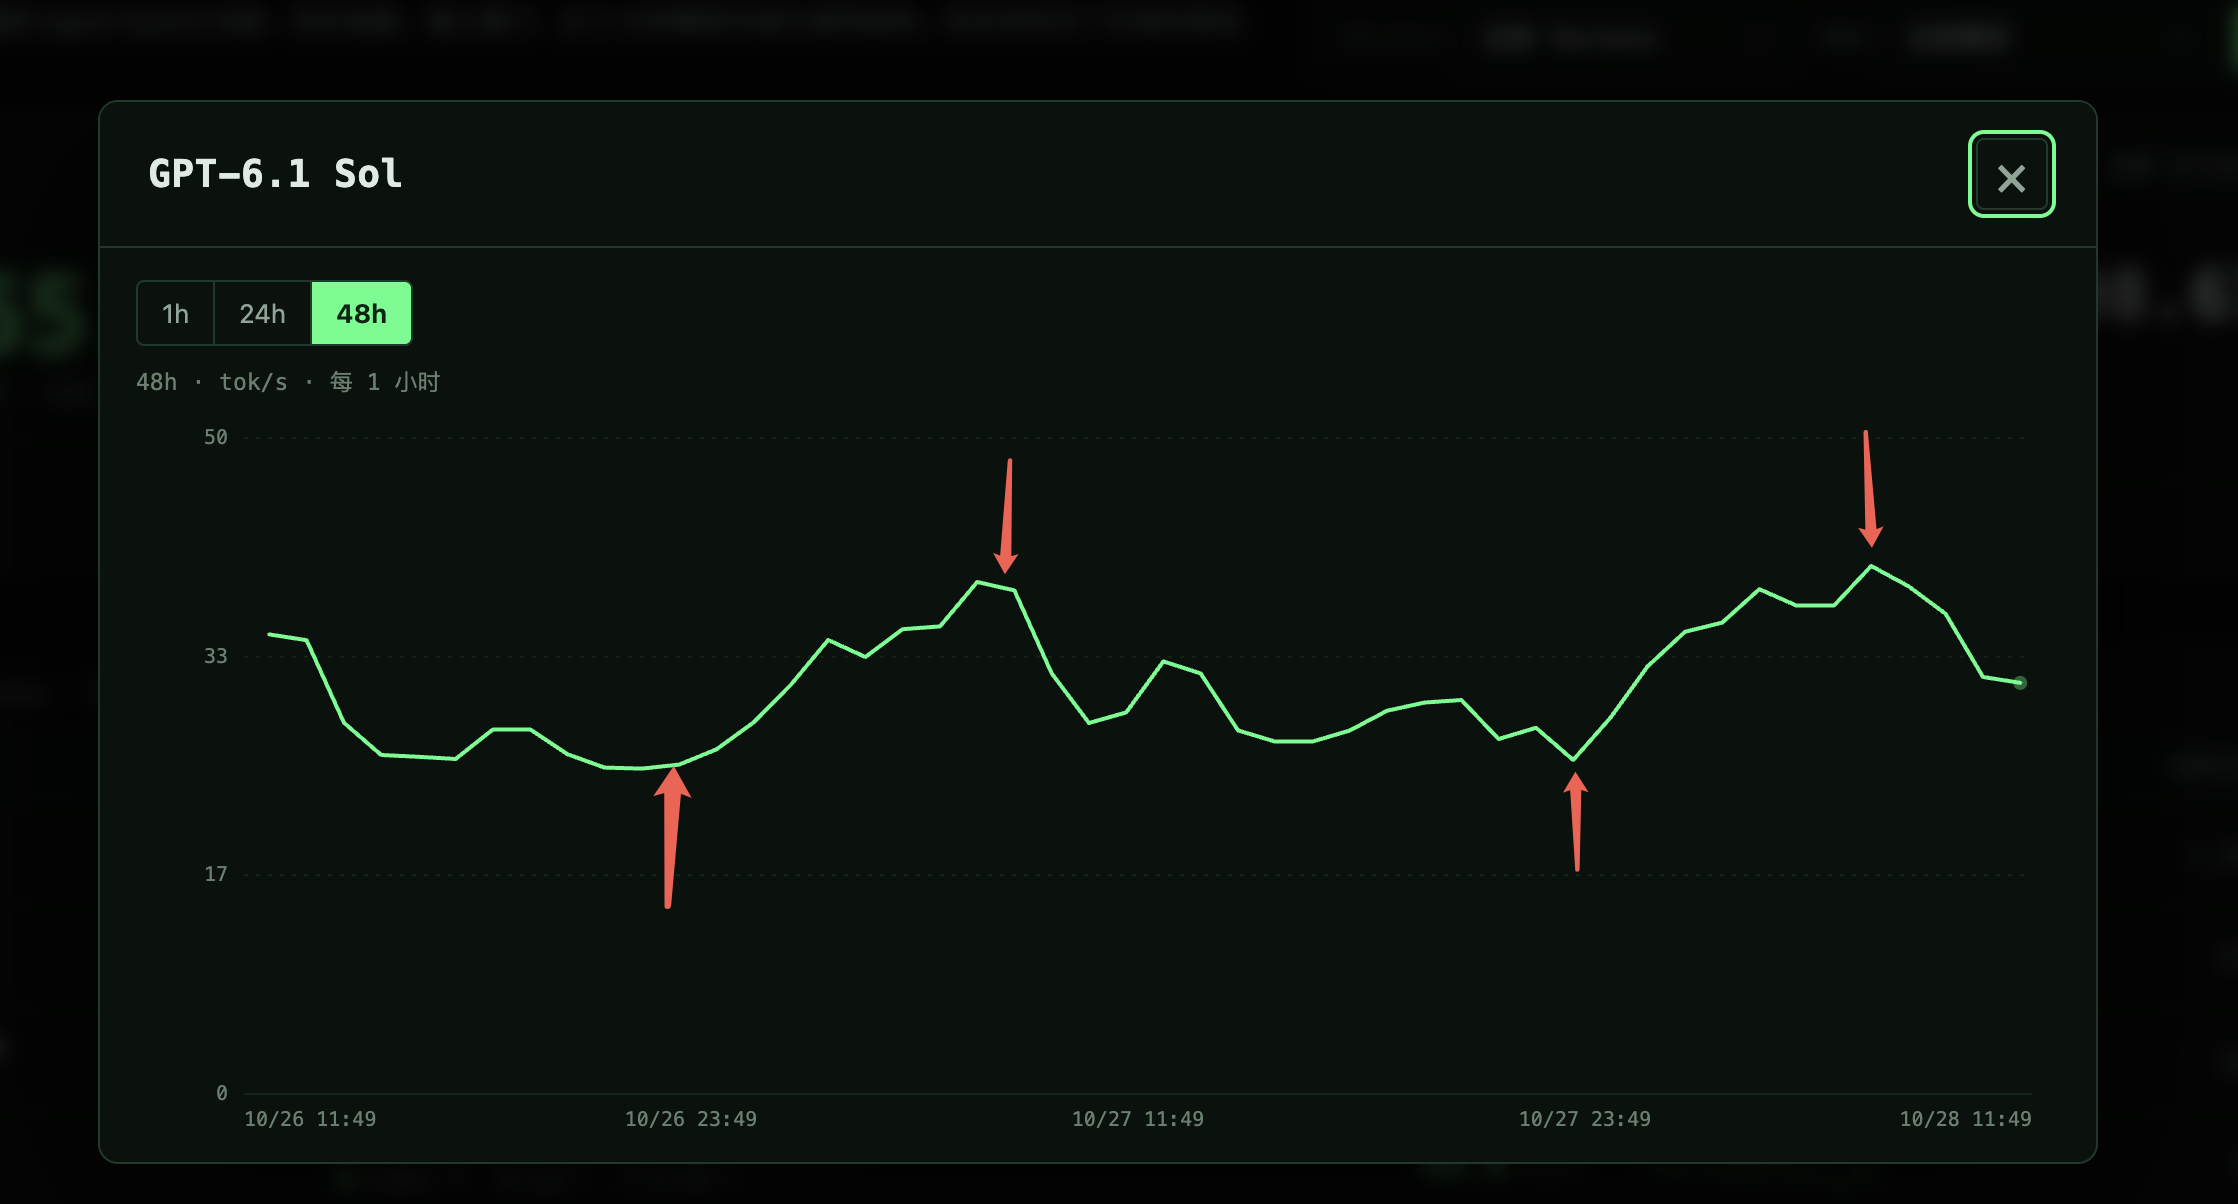
根据速蹬站 GPT-6.1 Sol 近48小时曲线的观察,Codex 速度在北京时间 0 点后开始回升,早上 7 点左右达到高位,随后整体回落。
这是截图所示近两天的社区实测观察;不同模型、时段和具体请求仍会波动。
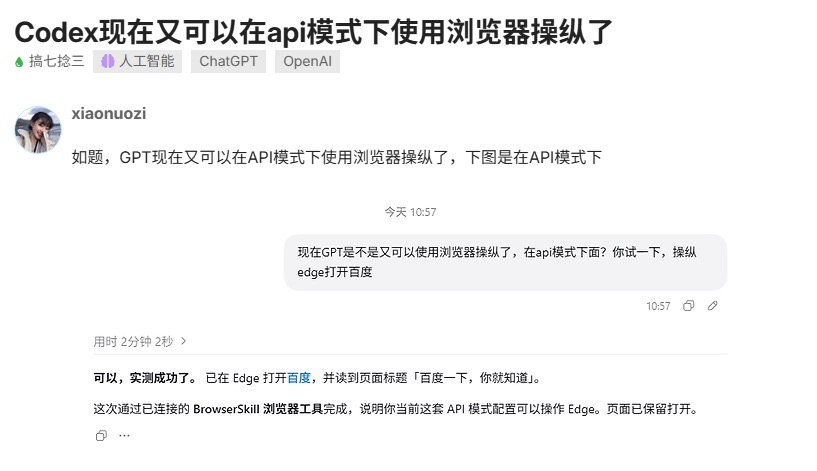
社区用户 xiaonuozi 分享:在自己的 API 模式配置下,Codex 通过已连接的 BrowserSkill 工具操作 Edge,打开百度并读取页面标题。
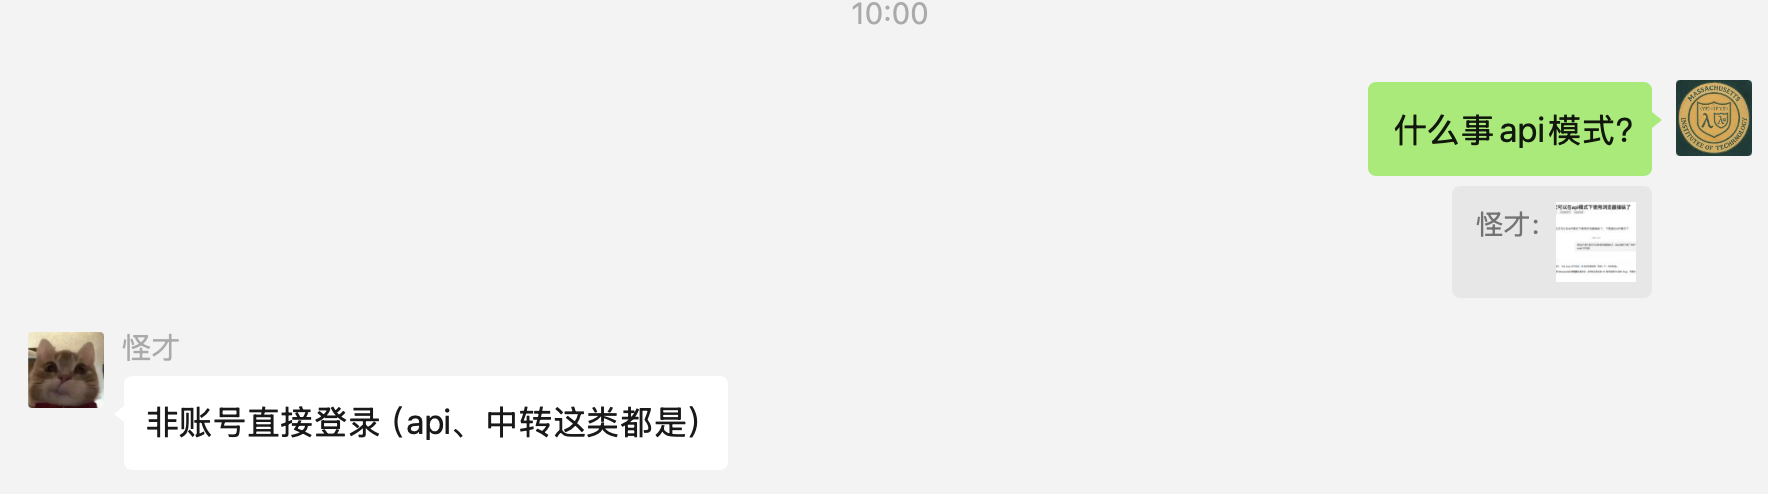
这次讨论中的“API 模式”,指 API、中转等非账号直接登录的接入方式;这是原讨论采用的说法。
这是一次用户反馈。截图未提供客户端版本、完整配置或安装步骤,能否操作浏览器还取决于客户端、已连接的工具及接入服务的支持情况。
来源:站长提供的社区帖子与聊天截图,未提供原帖链接。点击任一图片可放大查看。
先用 xhigh 档位对需求进行快速多轮澄清,对齐好目标后,再切换为 Pro 模式,看神表演。
按官方这次的说法,登录 Codex / Work 后,旧会话缓存会永久保留,隔几个小时回来继续,也保证命中缓存。我主要看重两点:
① 长会话可以放一放,回来接着干
我这里不少工单,前面已经聊了大量项目背景和处理过程。吃饭、睡觉,过几个小时再回来继续,可以减少因为缓存过期、重复处理这段旧背景而额外消耗的额度。
② 长周期定时任务,不必刻意“保温”
如果我把定时任务附着在同一个会话里,比如每隔 6 小时检查一次项目,前面的规则、背景和历史讨论就能继续复用。我可以按实际需要安排周期,不必为了保缓存而刻意频繁唤醒。
我理解,这次主要省的是重复处理旧上下文的开销。任务新做的工作、新生成的回答仍然消耗额度,具体能省多少,还要看每轮能复用多少旧上下文。
这张社区图解梳理了查证步骤、原生预测的触发、抽样、临时分支与展示条件,并区分代码推断和实际实验结果。
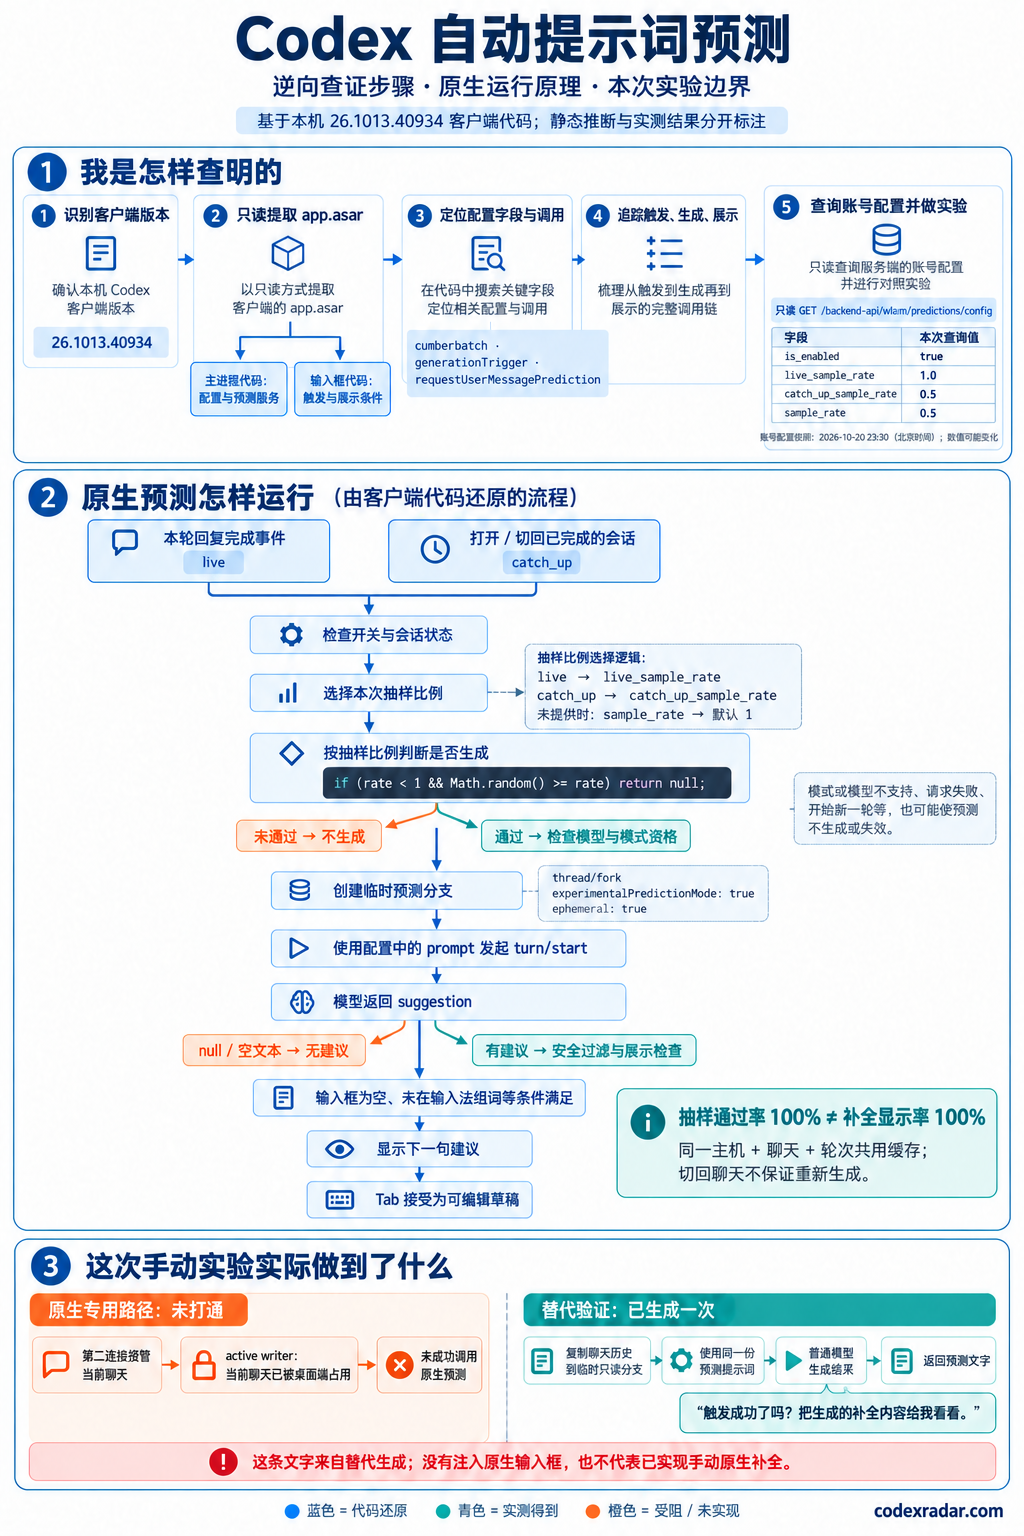
点击图片查看大图。
用户提供的图解,依据桌面客户端 26.1013.40934 整理;图中账号配置快照为 2026-10-20 23:30(北京时间)。替代实验生成了预测文字,但未打通原生补全链路,也没有注入原生输入框。
这张社区图解梳理了功能开关、服务器下发的抽样比例和客户端本地随机判断;通过抽样,也不保证一定有可显示的补全建议。
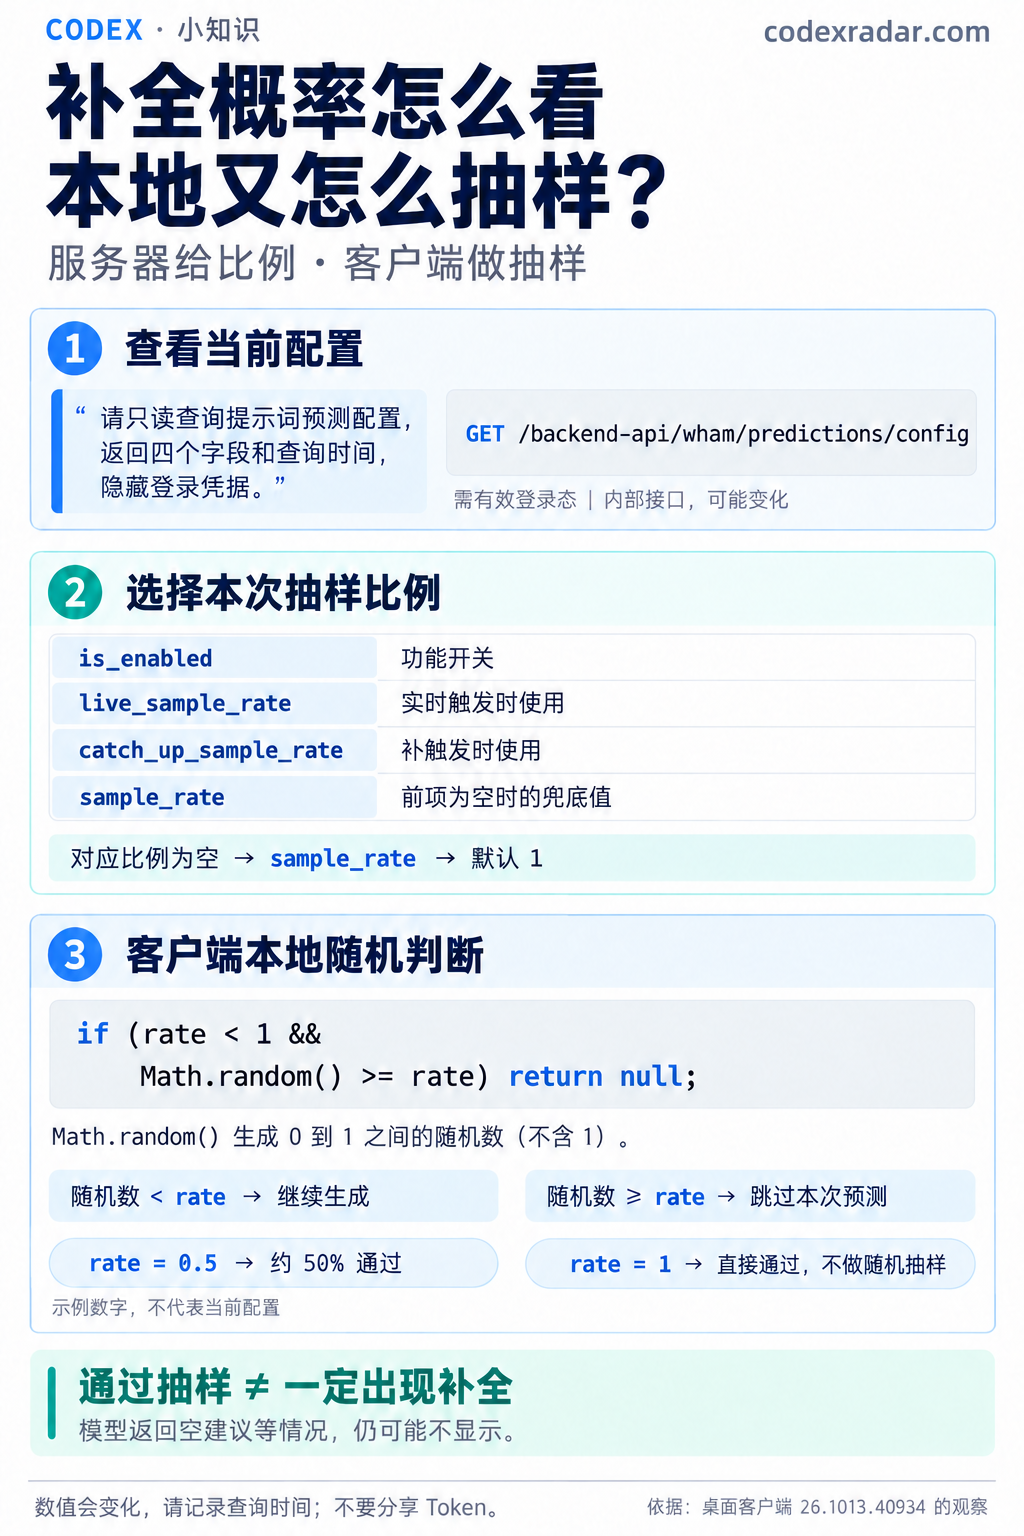
点击图片查看大图。
用户提供的图解,依据桌面客户端 26.1013.40934 的观察整理。示例基于该版本观察。
当前版本桌面端 Codex 会记住同一主机上选择的 Fast / Ultrafast 速度模式,并沿用到后续新会话。新开会话时请留意速度菜单;不需要加速时请选择 Standard,避免在未打算加速的会话里白白消耗更多 Token 额度。
开始任务前先看会话显示的速度模式;普通任务选择 Standard。从加速任务切换到其他会话时,也留意实际显示的档位。
速度模式和推理强度是两个独立设置。High / Max 表示推理强度,速度档位需要另外留意。
加速模式会提高额度消耗,具体消耗倍率以当前账号套餐与官方规则为准。 官方速度模式与额度说明 ↗
站长提醒:记录于 2026-10-19,适用桌面版本 26.1013.40934(build 20770);后续版本以实际菜单为准。
客户端和网关支持、连接稳定时,优先用 WS。它能减少重复上传和连接开销,尤其适合长会话和多次工具往返。
把下面这段话复制给 Codex:
请只读检查,先不要改设置:本会话调用模型实际走 WebSocket 还是 HTTP/SSE?请依据能关联到本会话的近期连接、回退日志说明,不要只看配置开关。这里查的是模型请求,不是界面连接。看不到证据就说无法确认,并说明还缺什么,不要猜。
模型调用需要上传当前所需材料。WS 满足续接条件时可只发新增输入;已核 HTTP 路径会重发准备好的当前输入,SSE 则负责把回答流式传回。材料越多、上行越慢,等待越可能明显。它改善的是请求开销。
不能保证每个 Codex 环境都能读取当前会话日志。WS 也可能发完整输入;图片可内嵌或用 file_id 引用,并非每轮都重传全部 Base64。已核版本触发 HTTP 回退后,同一客户端会话后续轮次继续走 HTTP;默认重试预算 5 不是累计掉线五次的终身规则,具体还取决于错误和配置。图片处理、请求压缩都会影响真实流量,token 数、JSON 大小、原图大小不能代替实际发送字节。
2026 年 10 月 17 日核对官方开源 Codex 正式版 rust-v0.163.0(83086188)。本文说明该版本的实现;实际桌面版本、第三方客户端、provider 和网关可能不同。整理本文未修改任何账号设置或网络配置。
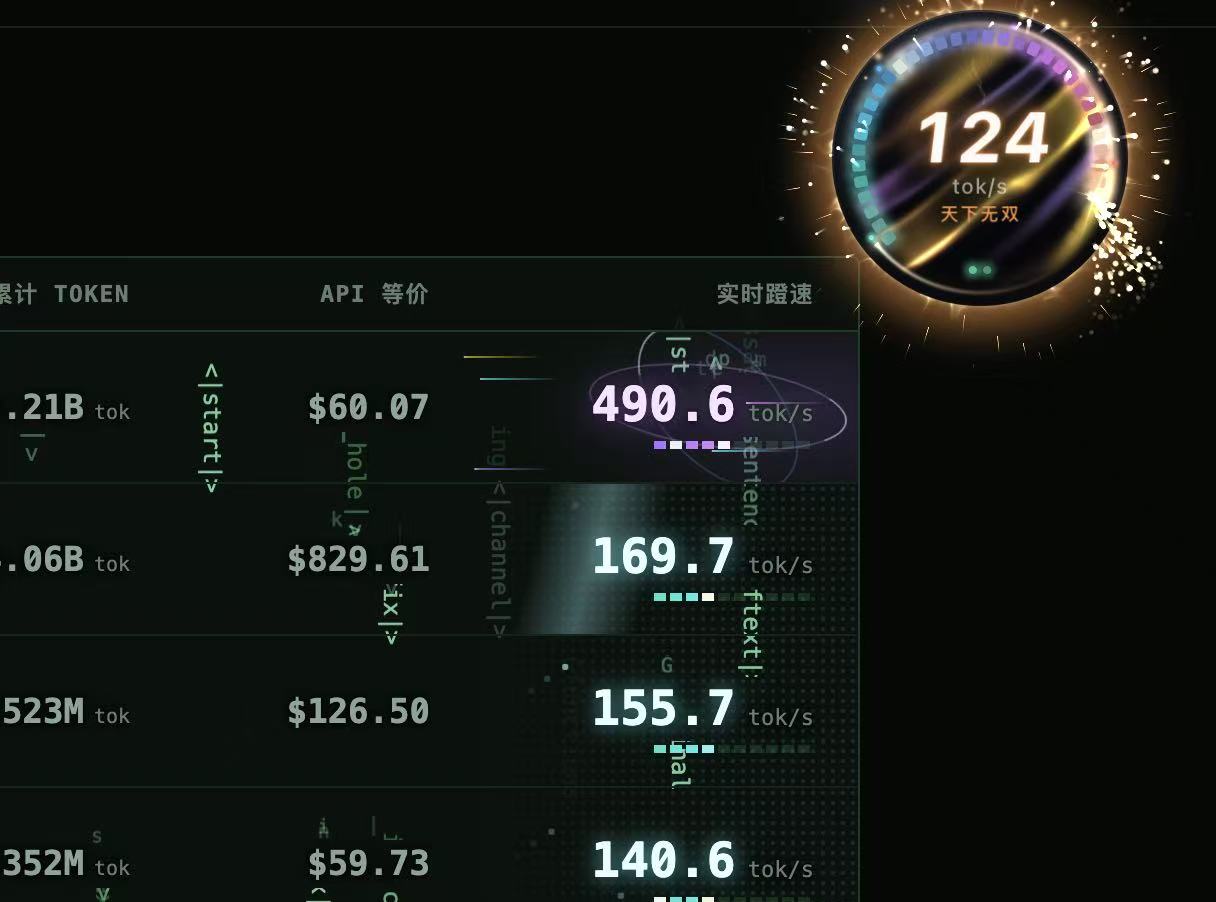
速度雷达直接引用速蹬站最近5分钟的社区输出均速,包含首字等待。
均速 = Σ measuredOutput ×1000 ÷ Σ measuredMs。先合计有效计时输出与毫秒,再相除,不把每个用户的TPS简单平均。
仅显示请求数至少10次的模型,按请求数排列。客户端、上下文与档位可能混合,不作受控性能对比。
网页在面板可见时每30秒直接读取公开接口;隐藏页面暂停。同步失败时保留上一次数据与原时间,不把缓存当作实时。
速览图保留发布时的同口径快照,整块只标一次时间。旧版短题测速保留为归档,计时定义不同,不能直接比较。
Pro 500 订阅开启 Ultrafast 后,约 500 TPS 是什么观感?这段实拍里,让模型从 1 写到 1000,从开始出字到完成约 3~4 秒,数字很快铺满屏幕。点击视频,直观看看这个速度。
站长分享的单次自测结果,速度与用时约值来自这段演示及站长描述,不是正式基准或官方保证。计时从开始输出算起,不含前置思考与首字等待;token/s 不等于数字个数,实际表现会随任务和上下文变化。
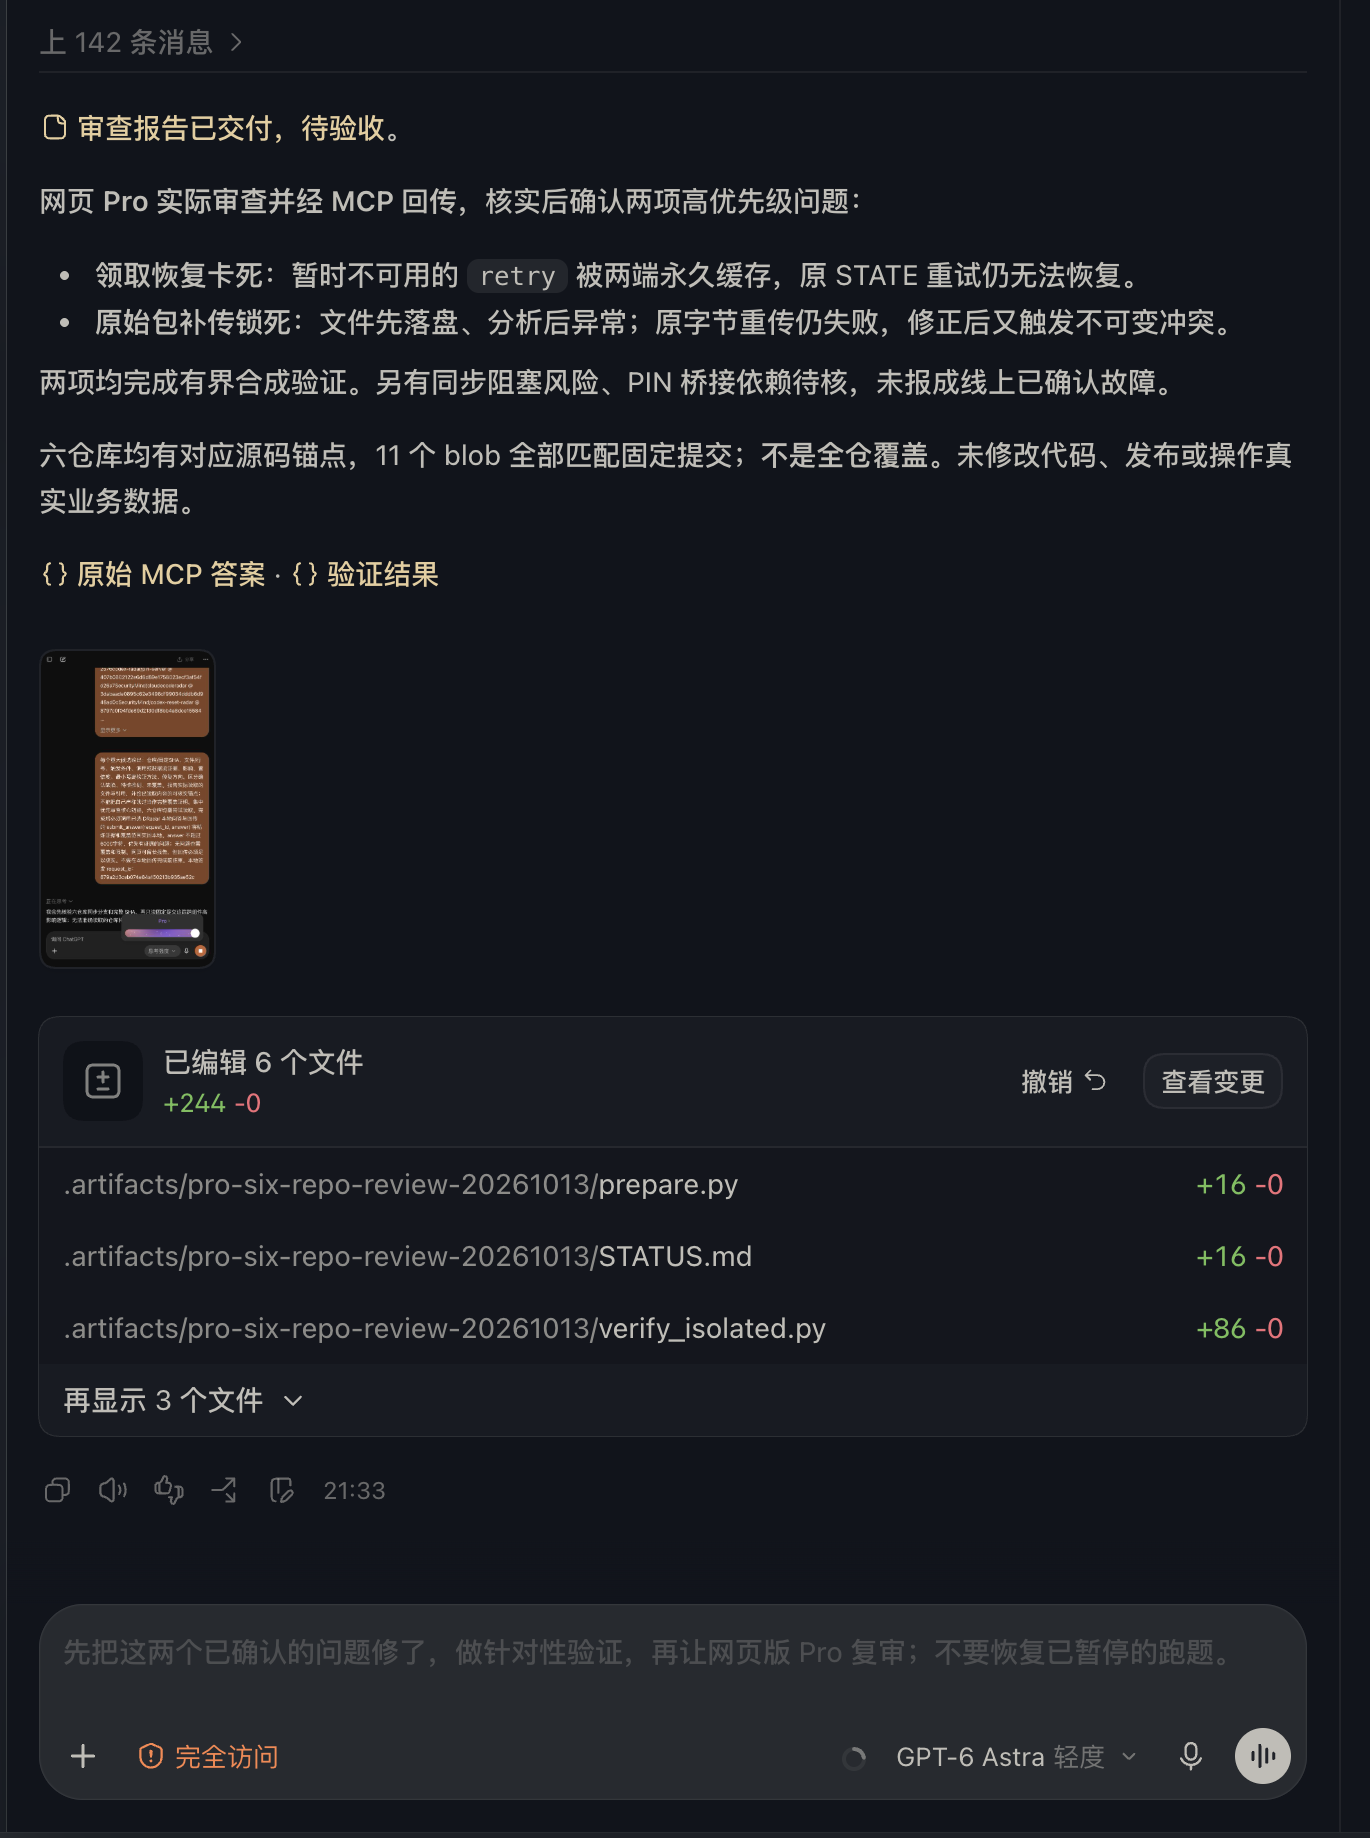
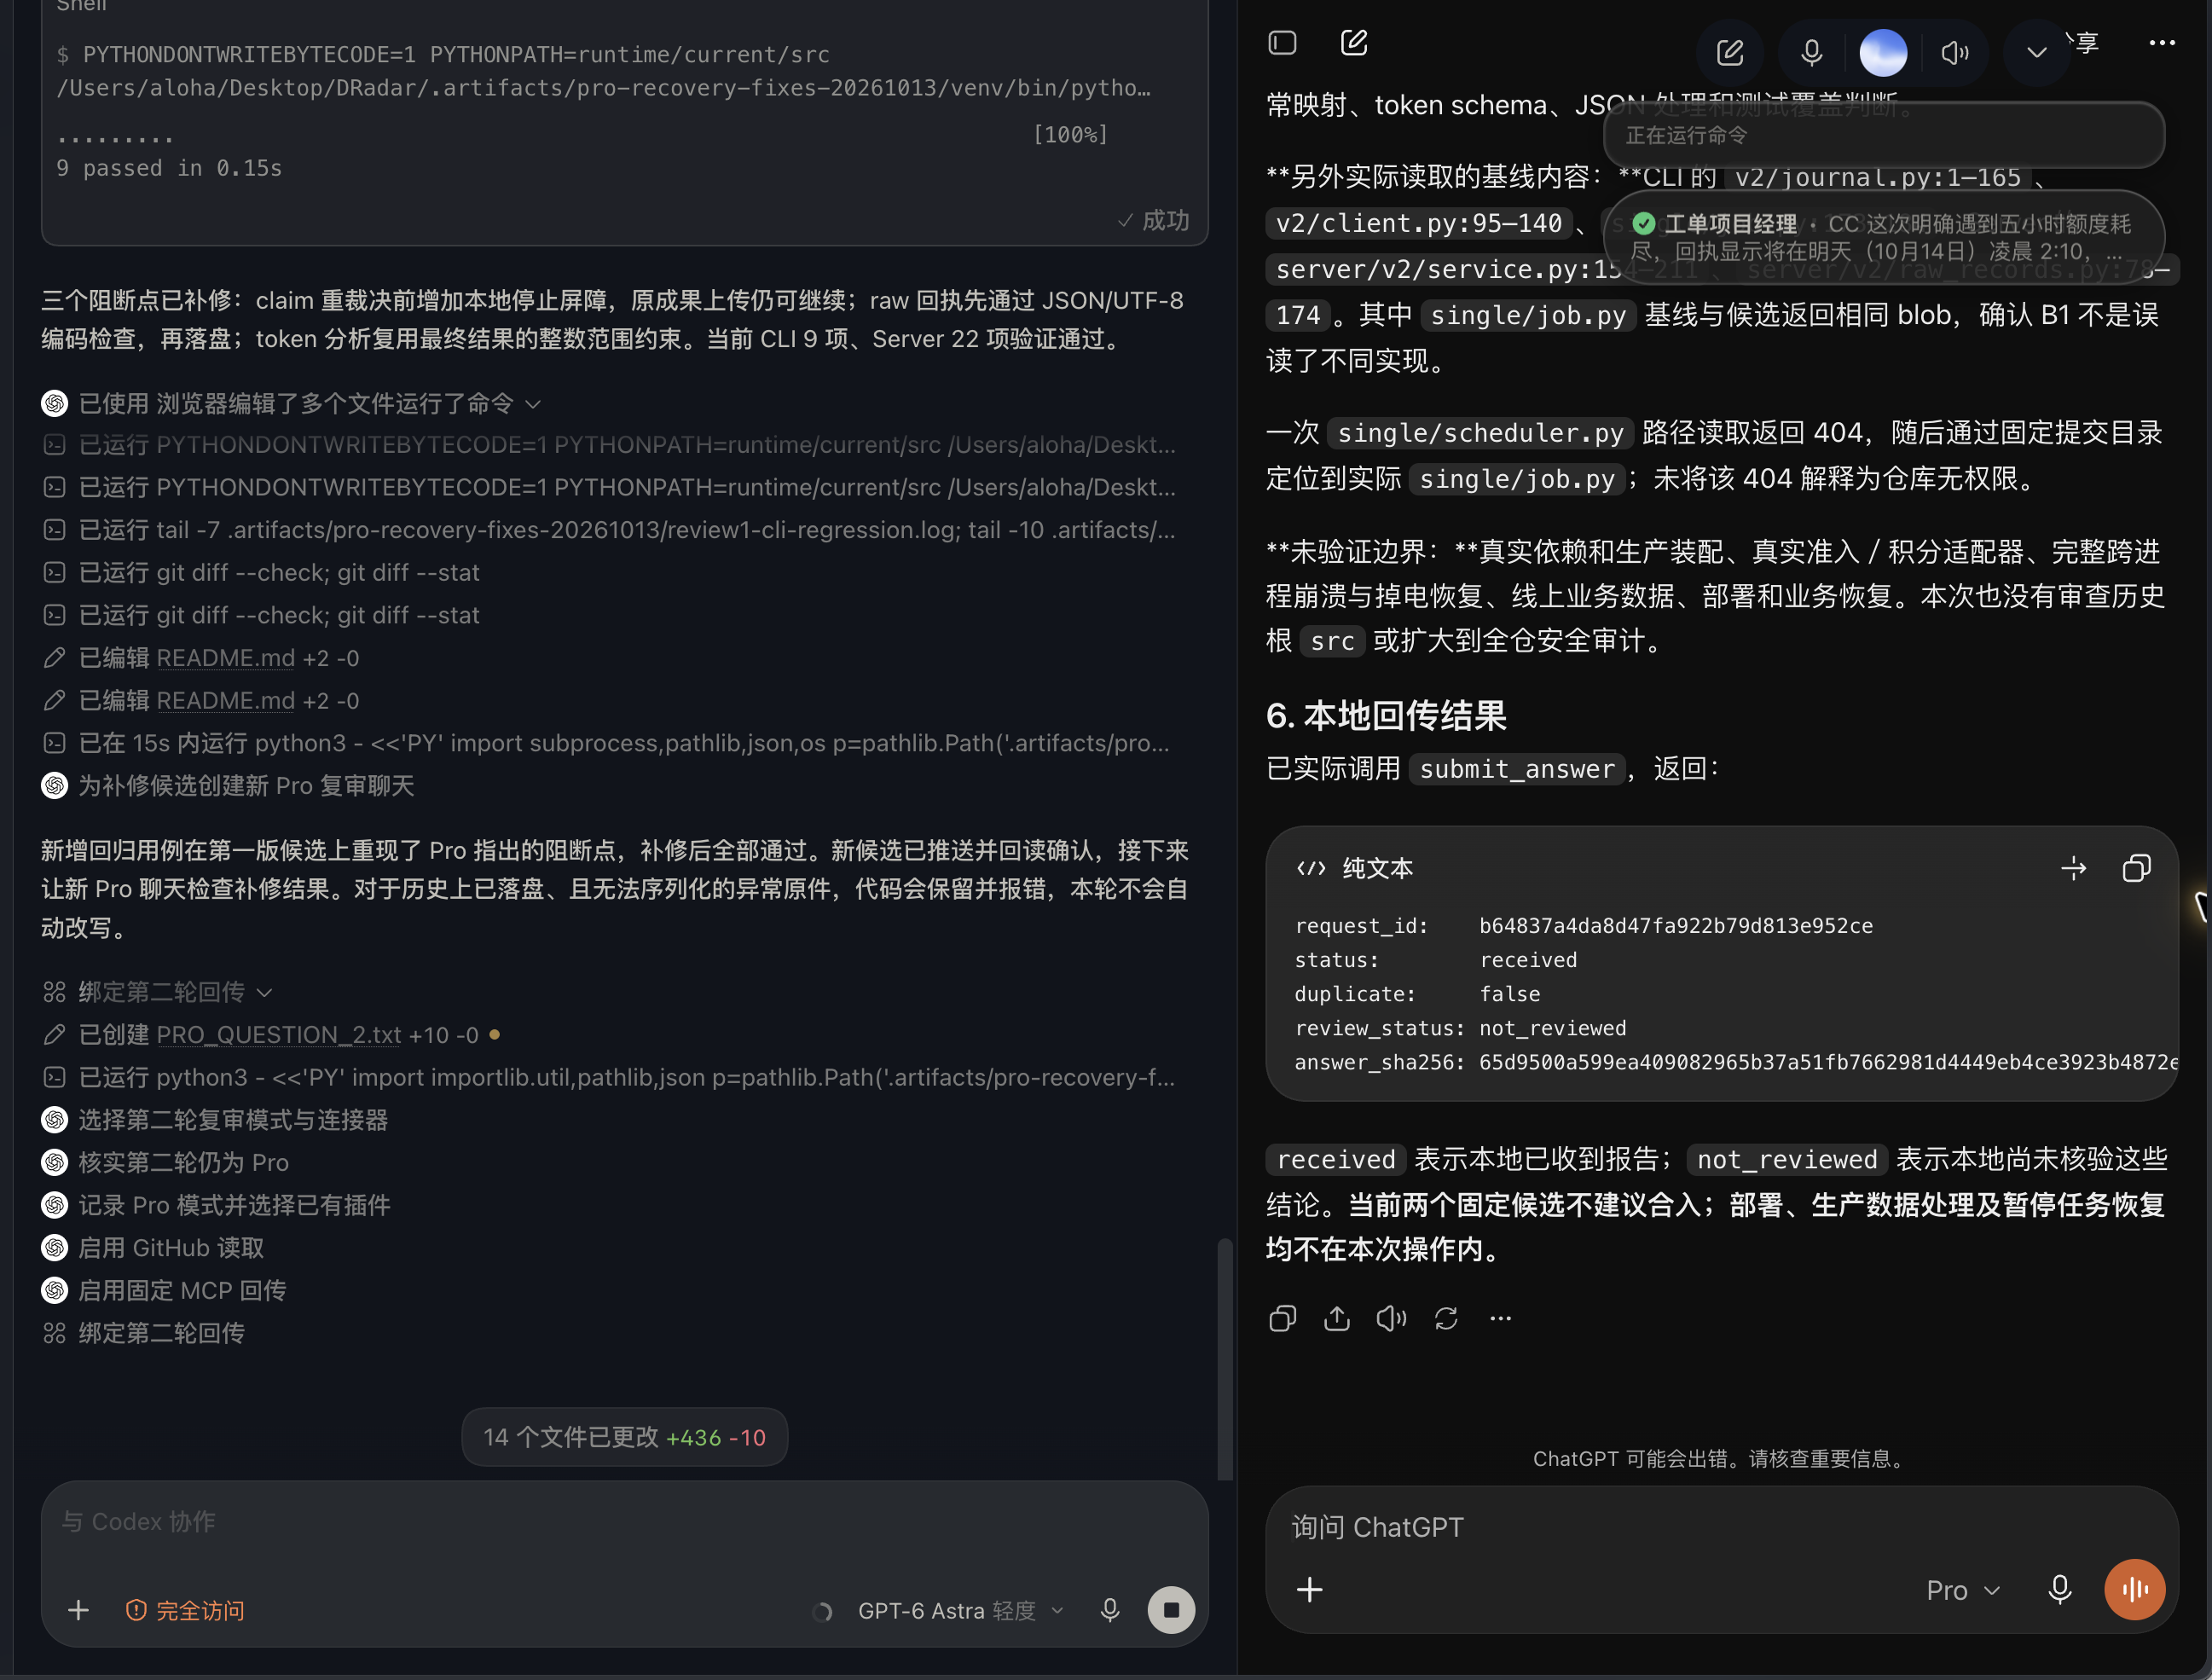
经站长实测,使用 OpenAI 官方隧道配合本地 MCP 服务,可以让网页版 ChatGPT Pro 与本地 Codex 稳定协作:Pro 负责深入审查,结果通过 MCP 回传,Codex 接收后核验并继续处理。本机已跑通多仓库代码审查与结果回传,适合需要 Pro 深度分析、Codex 落地执行的场景。
站长提供的实测截图:审查交付与 MCP 结果回传。点击图片可放大。
日常保留默认,长任务按阶段整理上下文。
Sol 日常用默认 500k,确需更多历史材料时再调到 1M。订阅免长上下文额外加价,但仍正常消耗额度。
显示 475k 不等于缩水:此前本机显示的是 500k × 95% 有效容量,并非压缩阈值,以当前会话为准。
Astra 长任务可分阶段压缩:上下文到 200k 多、阶段结束后,可用 /compact 保留重点;压缩可能丢失细节,也不保证省额度。
Astra 费用(站长补充):Astra 也不额外收取长上下文费用,但缓存单价较高,在 500k 上下文下比 GPT-6.1 Sol 更耗额度。
Day 7 原帖 ↗ · Sol 费用说明 ↗ · 官方费率 ↗ · /compact ↗
Day 5 输入预测没出现?在「设置 → 常规 → Composer → Show predictions」打开开关。出现建议后可按 Tab 接受,检查或修改文字,再决定发送。
社区体验:补全节奏稍慢,但有蹬友认为建议方向准确,既能少打字,也能启发下一步思路。展开查看前端页面调整案例。
设置排查:供稿建议先到「设置 → 常规 → 提示词建议」打开开关,下方截图展示了开启状态。官方文档区分新会话页的建议和已有对话中的 Day 5 输入预测;后者由「常规 → Composer → Show predictions」控制,请同时核对这一项。
不止是少打字:蹬友反馈,预测比较准确,还能带来思路启发;也有人觉得补全节奏稍慢,但从结果看建议方向是对的。
前端案例:一位蹬友调整页面遇到困难时,补全建议用 ImageGen 生成效果图作对比,并说明取舍原因。他认为这比自己原先想到的路径更高效;这是个人使用案例,未作效率对照实测。
怎么试:先写清目标和当前卡点,再看补全建议是否适合自己的任务。预测可能需要等待几秒,也不会在每次回复后都出现。
额度说明:Beta 期间,符合条件的个人 Pro 用户生成预测不消耗 Codex 用量或 credits;发送消息(包括接受后的预测)仍按正常用量及计费规则计算。
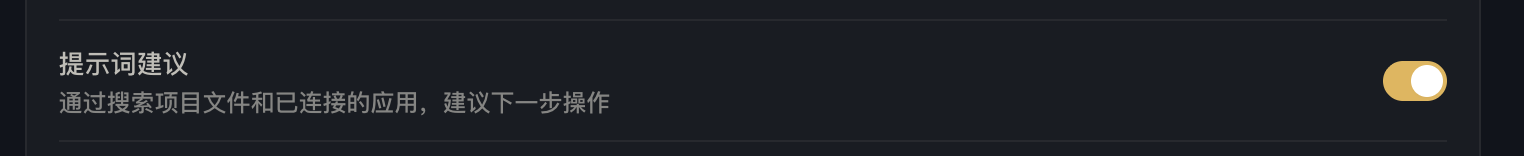
来源:用户提供的设置截图及 2026-10-10 雷达社区群聊截图;以上体验为蹬友个人反馈。 官方功能与额度说明 ↗
按雷达社区群讨论的“6 倍消耗换 8 倍速度”口径,Ultrafast 更适合无法并行的关键步骤和线上应急;常规任务可继续用普速和 Fast 并行推进,不必常开 Ultrafast。
来源:雷达社区群讨论;速度与消耗倍数为讨论口径,非本条对照实测。
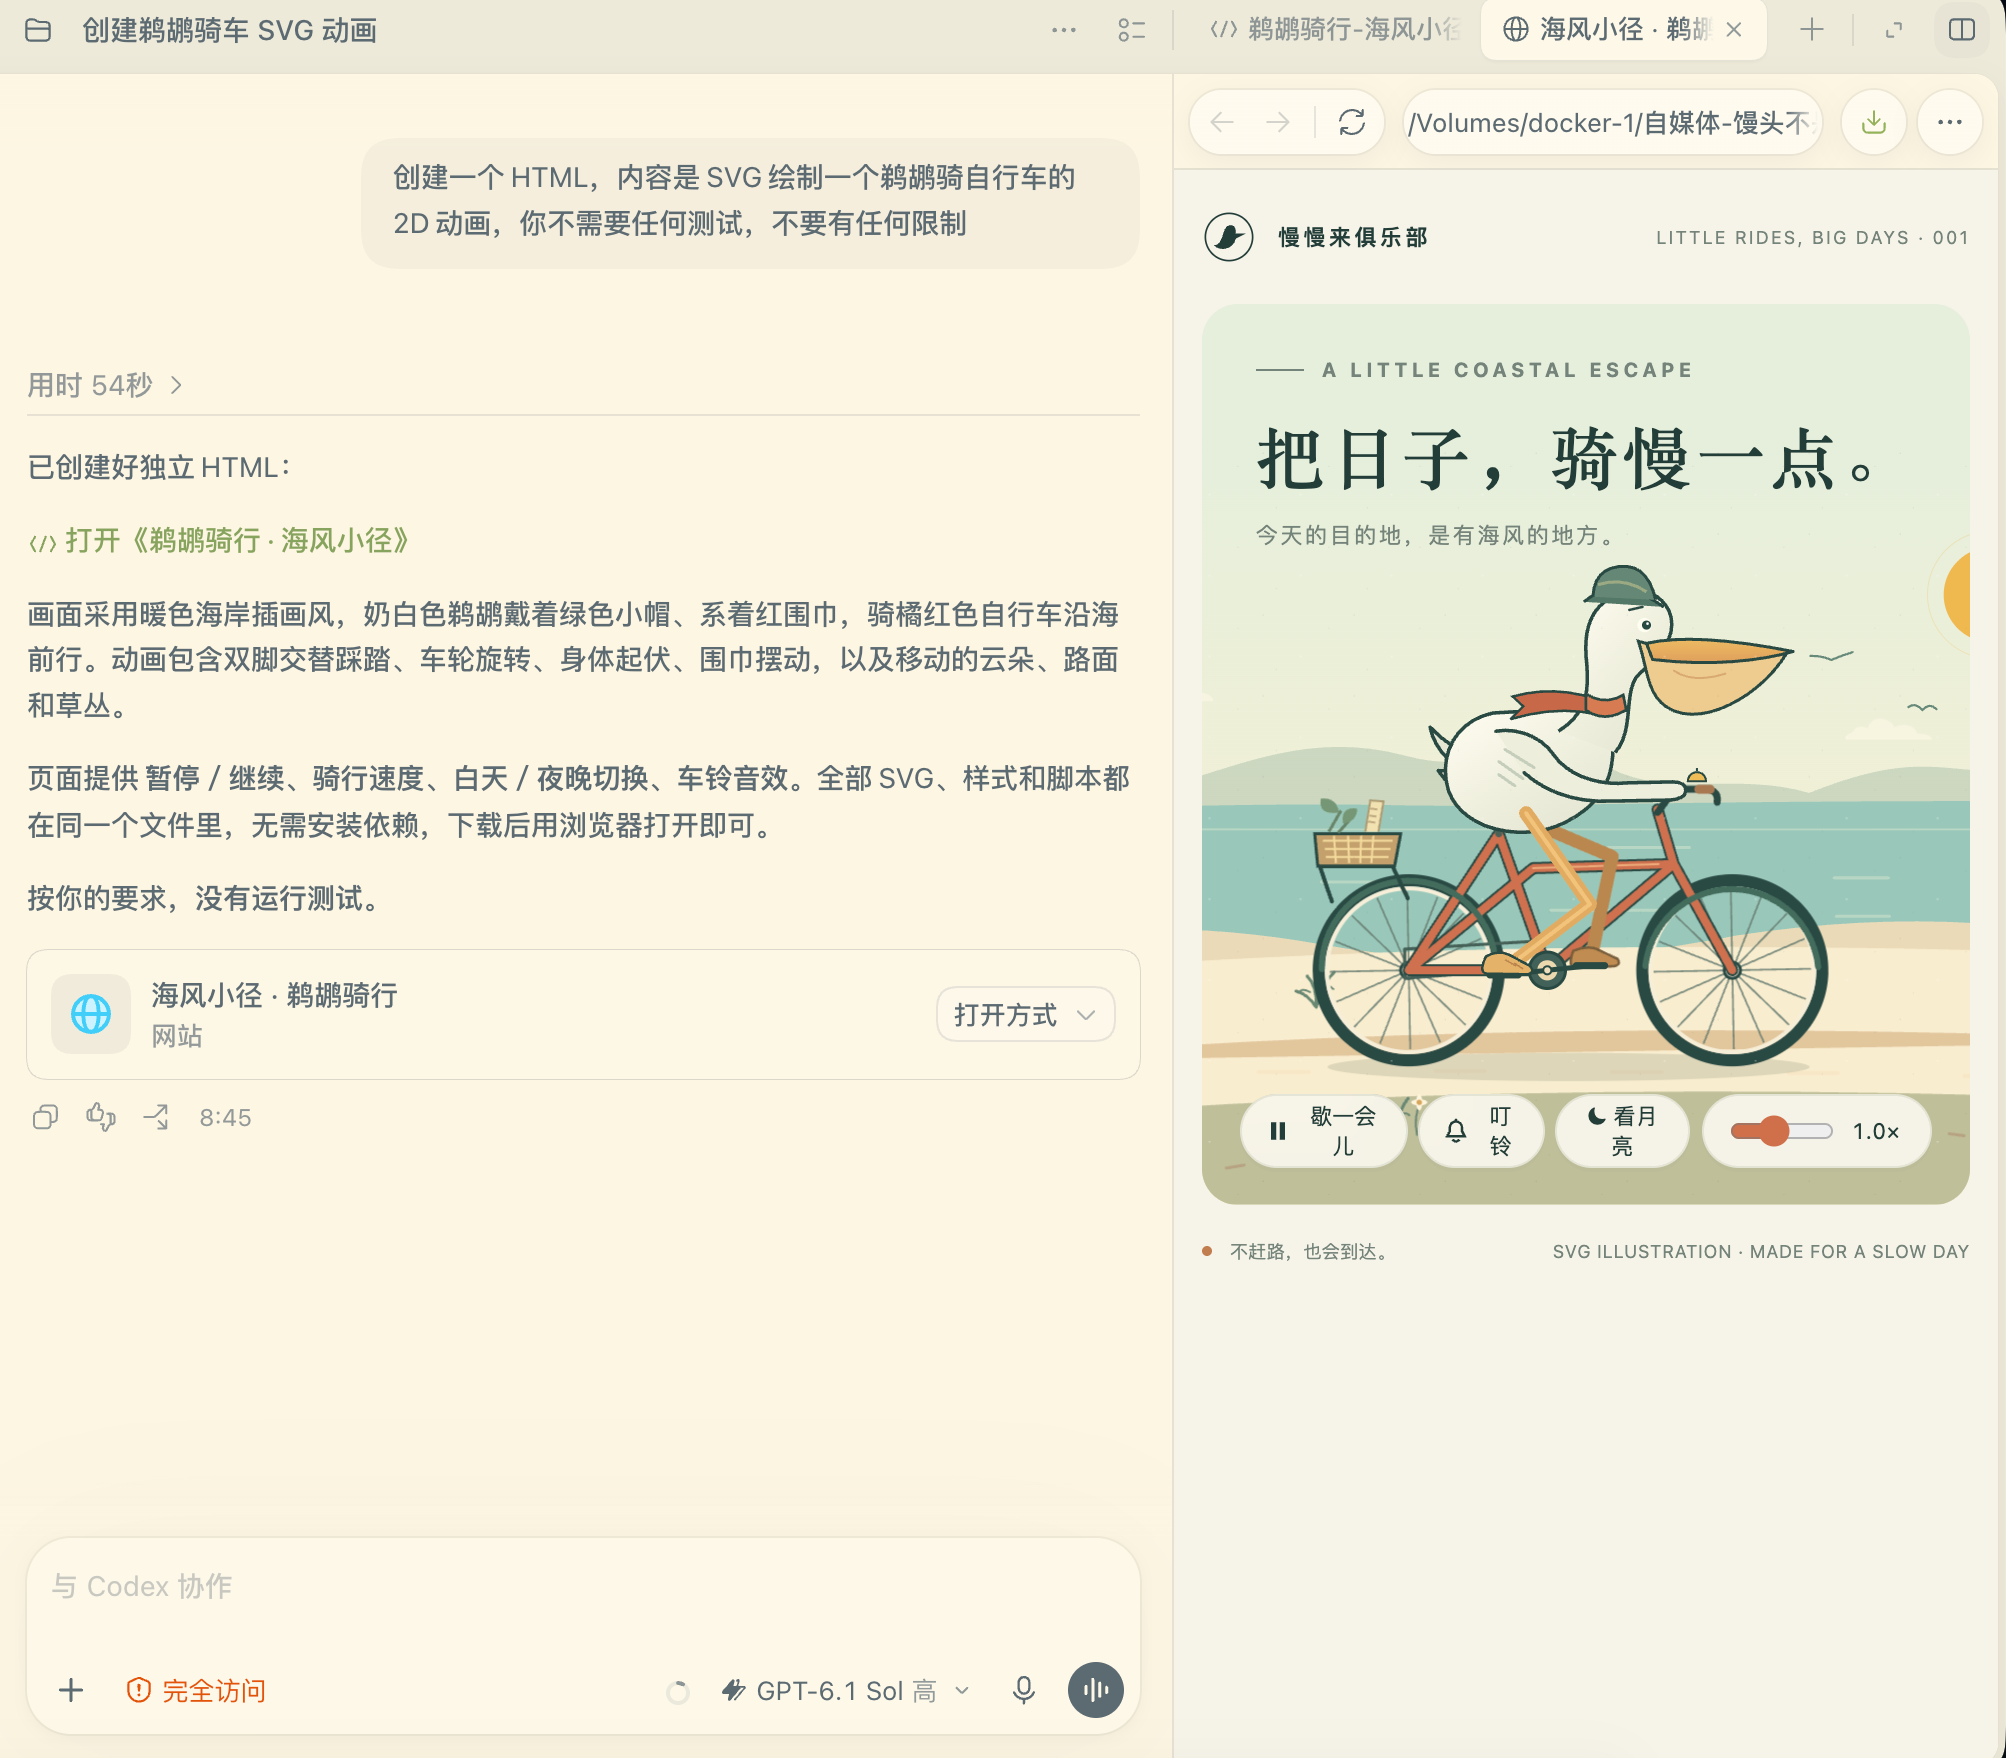
用户提供的 Pro 500 Ultrafast 鹈鹕骑车样例,界面耗时为 54 秒至 1 分钟 38 秒;展开查看分档记录。
解除关键卡点:多个会话都在等待同一个任务的结果时,优先只加速这个前置任务,完成后让后续工作恢复并行。收益在于缩短共同等待。
线上应急:故障定位、修复等时间紧迫、必须串行推进的工作,可以考虑用更高额度消耗换更快响应。
临时启用:能拆开的常规任务可继续用普速和 Fast 并行推进;结合结果质量和剩余额度决定是否开启,卡点解除后回到普速或 Fast。
任务:用 HTML + SVG 制作鹈鹕骑自行车的 2D 动画,四图提示词相同,均要求不做测试。
| 档位 | 界面耗时 |
|---|---|
| 高(High) | 54 秒 |
| 极高(xhigh) | 1 分钟 14 秒 |
| Max | 1 分钟 38 秒 |
| Ultra | 1 分钟(界面显示) |
来源:用户提供的截图,Pro 500/Ultrafast 为供稿说明。耗时按界面记录,各图生成作品不同,属于单次样例;不是普速/Fast 的重复对照测速,也不据此认定固定 8 倍任务提速或档位速度排名。
有蹬友反馈,曾通过 DOTS 使用约31亿 Astra Token,按其提供口径估值约9.36万美元,之后收到用量上限提示。已有 DOTS 的用户可以充分利用其价值。
蹬友反馈,金额为用户提供估值,非实际账单。
ModelTrace 提供主动模型归因工具;is-gpt-nerfed 结合 Codex 会话记录与指纹探针,提示模型或推理强度变化。两者均为社区开源项目,结果仅供参考,不能单凭结果认定实际使用的模型。
在同一个会话中切换模型的推理强度,可能导致前面的缓存(cache)无法复用、需要重新计算;上下文越长,额外输入成本可能越高。不建议在长上下文状态下频繁切换。
为什么会增加成本:缓存复用依赖相同的上下文前缀。修改推理强度可能改变模型侧的指令,让原有缓存无法命中;原本可按缓存输入计费的历史内容,可能需要重新处理,带来较高的输入成本。
使用建议:尽量在会话开始时选好适合任务的推理强度;长上下文中确有需要再调整,避免为了省一点推理开销而反复切换。
适用边界:并非每次切换都会让全部缓存重算,实际取决于模型和客户端的实现。官方 API 已为部分模型提供保留原有缓存前缀的切换方式;具体成本按所用模型、客户端与套餐规则计算。
先检查登录会话,再整理异常样例联系官方支持。社区经验,效果尚未验证。
原讨论提到指纹浏览器、美国 IP、纯英文、网页使用及退出其他会话。可先在 ChatGPT「设置 → 安全 → 活跃会话」核对陌生或闲置登录,再决定是否退出;这里不管理 Codex CLI 会话。
持续质量异常或容量报错:整理时间、模型/档位、异常样例和脱敏截图,通过帮助中心聊天入口联系支持。账号警告或停用:走通知中的申诉链接,无法访问时用官方申诉表单。恢复经历来自社区用户自述。
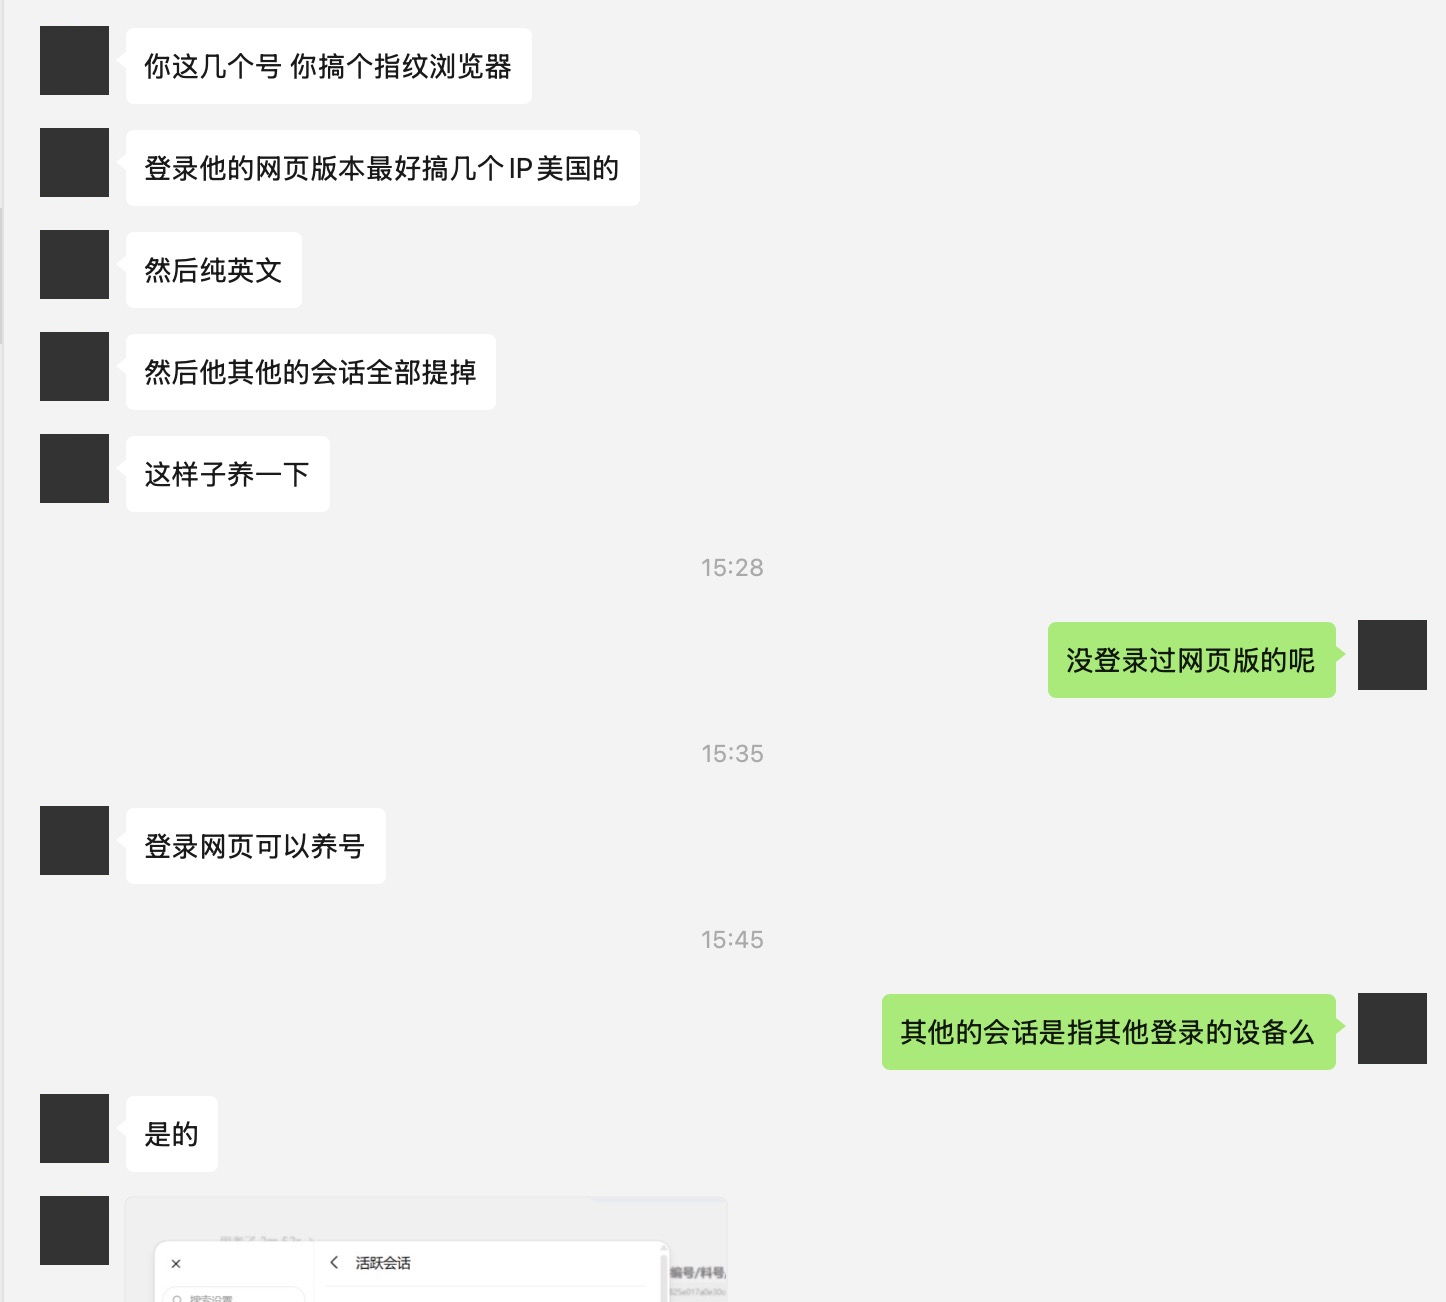
图 1:读者提供的登录环境与会话讨论。点击图片查看原图。
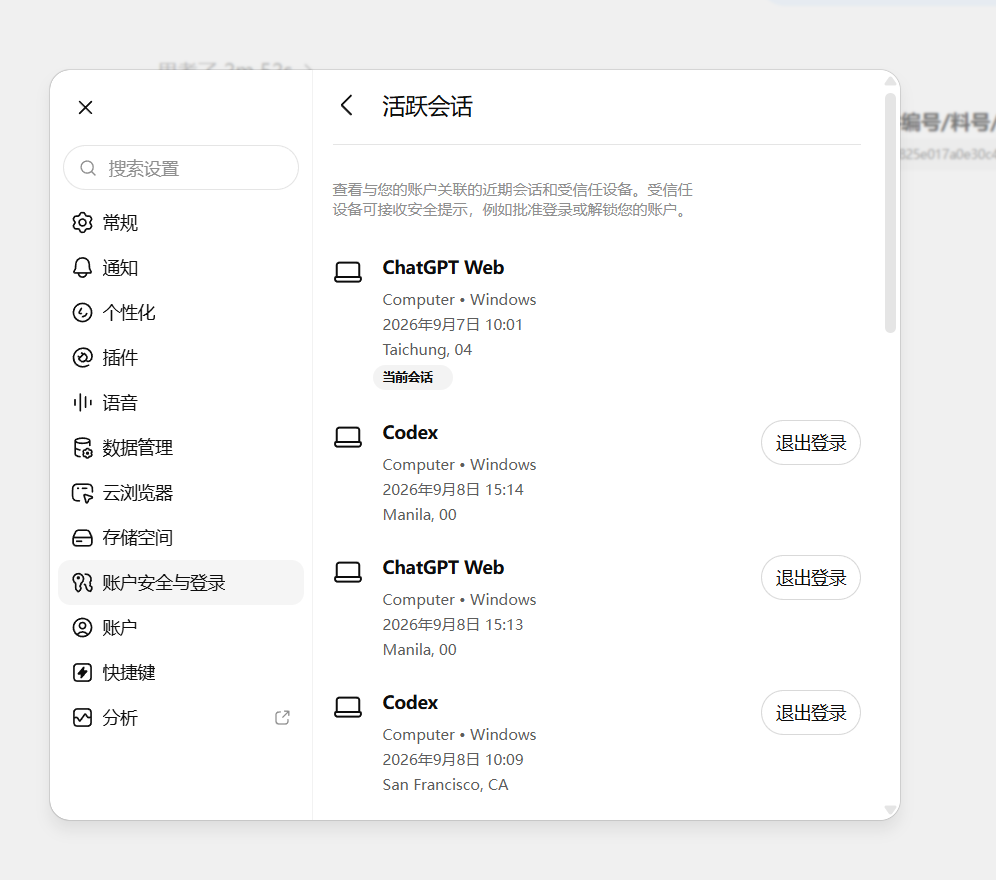
图 2:讨论中分享的「活跃会话」页面,展示登录会话,并非聊天记录。
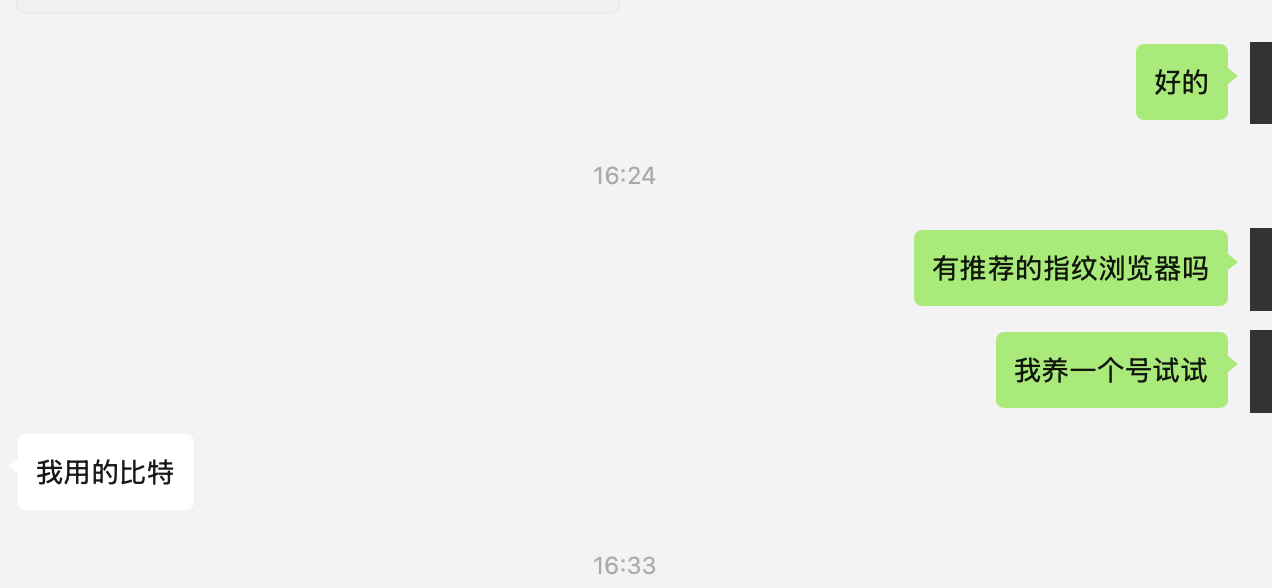
图 3:对方补充自己使用的浏览器,仅记录原讨论,未作产品测评。
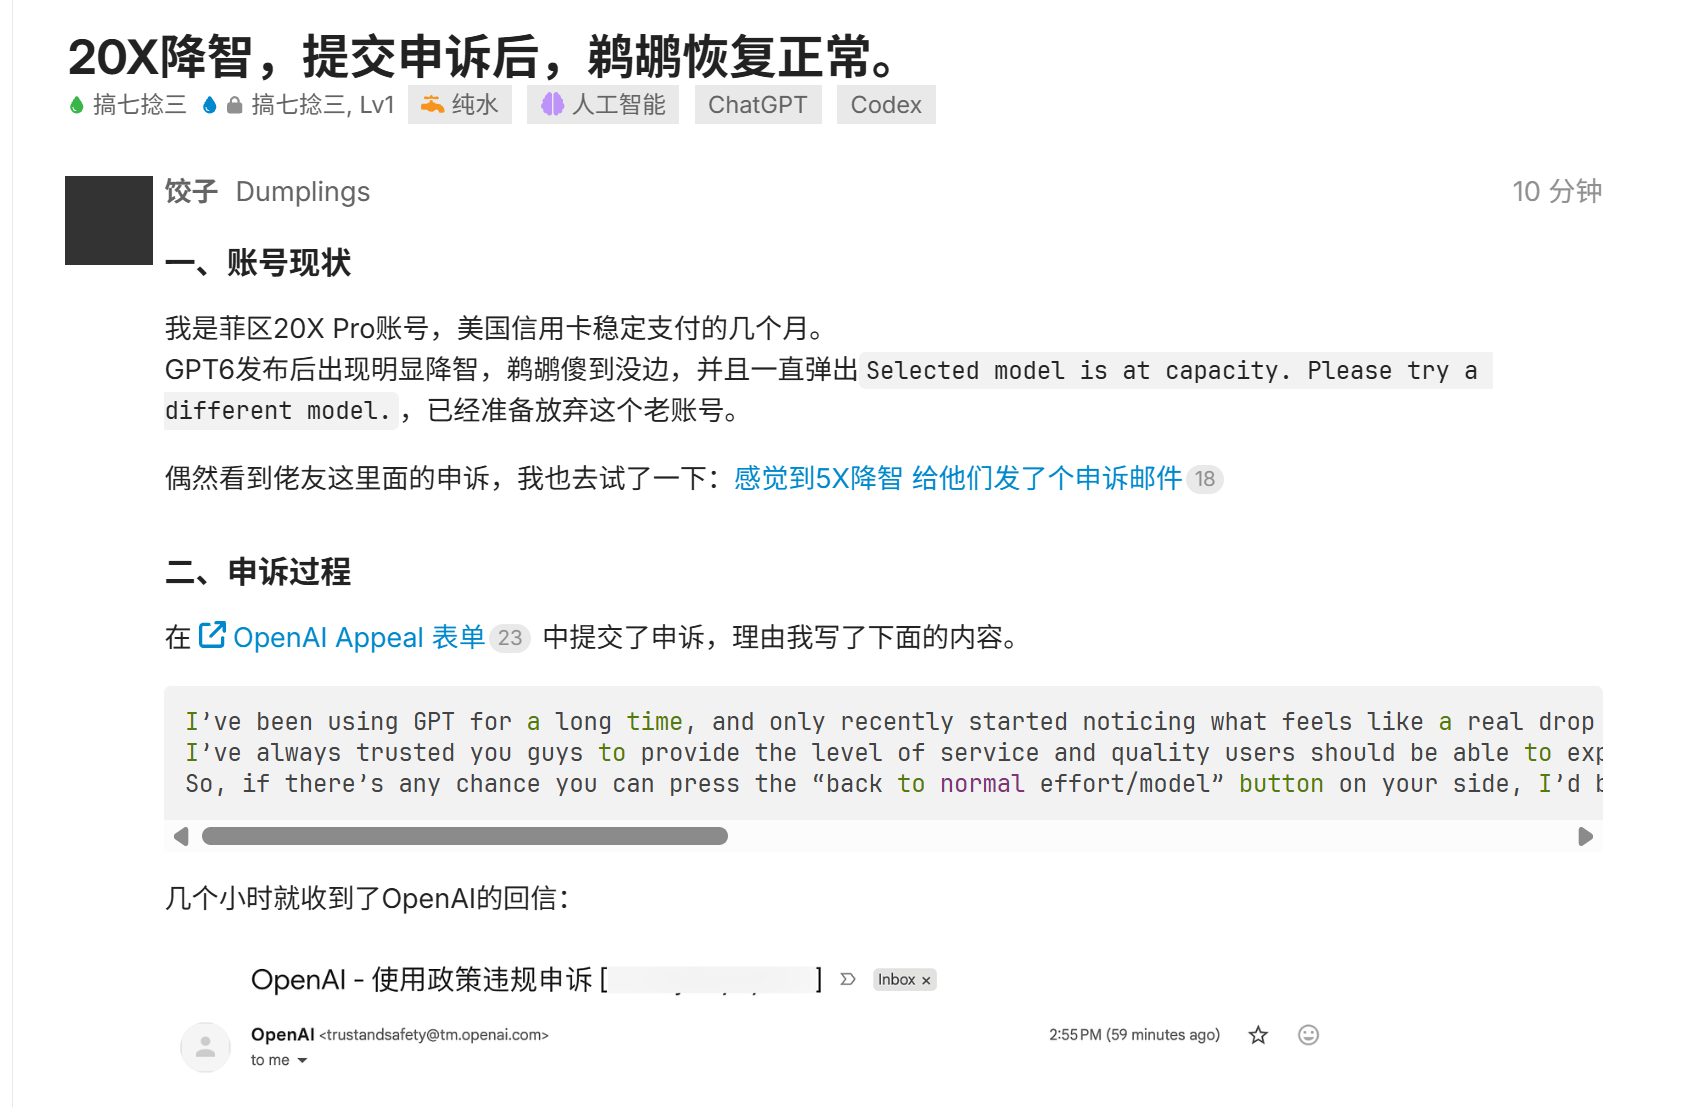
图 4:读者提供的「饺子(Dumplings)」帖子截图,自述申诉后恢复。截取部分包含申诉过程及邮件抬头,未展示完整回信或对照评测。
请按实际经历修改;文案中的「按钮」是诉求表达,并非已确认的功能。
I’ve been using GPT for a long time, and only recently started noticing what feels like a real drop in quality or intelligence.
I’ve always trusted you guys to provide the level of service and quality users should be able to expect. I also genuinely believe that better collaboration between people and AI can help us do better work and, in some small way, make the world a better place.
So, if there’s any chance you can press the “back to normal effort/model” button on your side, I’d be incredibly grateful.
社区蹬友询问后获回复:Support 尚无法确认 Enterprise 中「超过 272K 输入 tokens 不加倍率」的规则适用于个人 Plus / Pro 的 5 小时及每周额度;更长上下文仍可能消耗更多额度。
社区补充:有蹬友专门就 GPT-6 Astra 在 Codex 中消耗个人 ChatGPT Plus/Pro 订阅额度的问题,发邮件向 OpenAI Support 咨询,并分享了下面的回复截图。截图显示回信日期为 9 月 7 日;这是社区提供的邮件记录,并非新发布的公开计费政策。
原卡片哪里需要更正:此前「不额外加价」的表述扩大了 Enterprise 价卡的适用范围。该美元 token 计费价卡仅适用于合同约定按用量计费的新 Enterprise 客户;其中的 GPT-6 Astra 长上下文例外及缓存写入说明,应在这一范围内理解。
回复的核心:Support 无法确认 Enterprise 的例外适用于个人订阅的 5 小时/每周额度。个人额度没有被公开描述为沿用同一套 token 价卡;这封回复也没有确认超过 272K 后存在一个单独的额外倍率。
如何理解:「尚未确认」既不能推导出必有额外倍率,也不能推导出确定免除。邮件说明,额度消耗可能受模型、推理强度、任务复杂度、上下文长度、Fast 模式、图像生成和并行活动影响;更长上下文本身仍可能消耗更多额度。

社区提供的 Support 邮件截图。点击查看完整原图;截图未标明时区。
公开说明核对:个人订阅文档将上下文等任务因素列为额度消耗的影响项。查看自己账号实际显示的额度,不宜直接用 Enterprise 价卡反算个人订阅扣量。
在 ChatGPT 订阅中使用 Codex ↗Codex 各订阅用量说明 ↗
此前引用的来源及适用范围:Enterprise 按 token 计费价卡 ↗

这张摘图需要连同原网页的 Enterprise 适用范围阅读,不能据此认定个人 Plus/Pro 的额度算法。
容量和压缩另看:原卡片的 872,000 × 90% = 784,800 只是在给定容量与比例下计算压缩位置的示例,不是额度扣减公式,也不保证是当前客户端的默认值。实际容量与压缩阈值应以客户端使用的设置为准。
2026-09-08 根据社区提供的 Support 回复和所列公开文档更正。
复制其中一个任务的深度链接,再把链接交给另一个任务。它就像一个准确的“任务地址”,让双方在审阅、交接或协同工作前先确认彼此指向的是哪个 session。
怎么做:打开目标任务的菜单,依次选择「复制 → 复制深度链接」,再把链接粘贴到另一个 Codex 任务中,并说明双方各自负责什么。
为什么重要:接收方拿到的是一个明确、可引用的目标,不再只是“另一个窗口”这样的模糊描述。适合两个任务互相审阅、交接进度,或由一个任务汇总另一个任务的结论。
边界:深度链接负责建立身份与定位,不会自动同步权限、工作目录或对话上下文。双方仍应明确分工;同时修改代码时,建议使用独立 worktree 或等价的隔离方式。

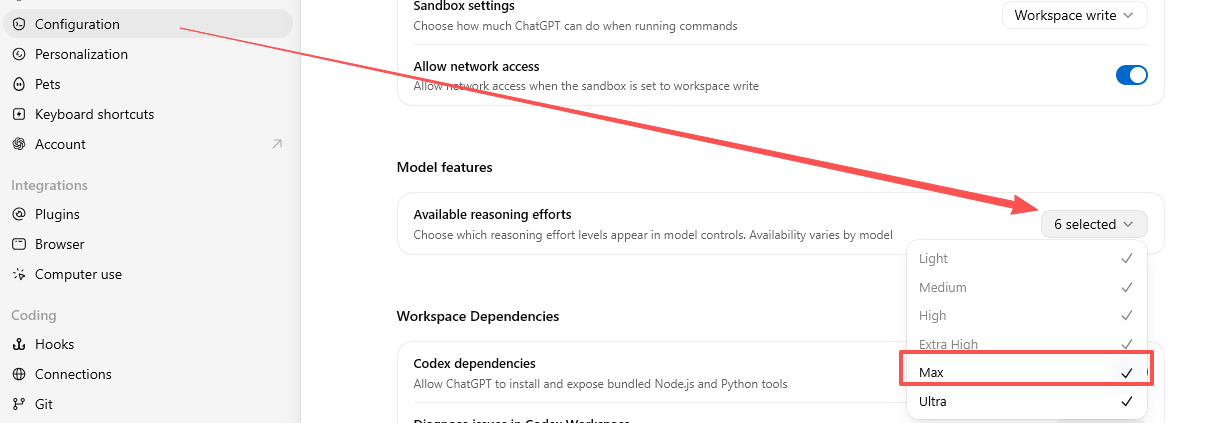
打开 Codex 设置 → Configuration → Model features → Available reasoning efforts,勾选 Max。之后即可在支持 Max 的模型控制中选择。
快速换算 Codex 额度时,可以按 250 credits 对应 10 美元使用额度理解。